Chatbot RAG : votre visiteur parle français, votre corpus parle anglais
Embedding cross-lingue, reranker multilingue, langue de la réponse : les trois endroits où un chatbot RAG se joue quand la question et la documentation ne sont pas dans la même langue.
J’administre un certain nombre de chatbots IA, sur des sites et avec des outils très différents. Un cas revient sans cesse : la base documentaire est en anglais (documentation produit, fiches techniques, articles de fond), et une partie des visiteurs pose ses questions en français. Parfois c’est l’inverse, un corpus français et des visiteurs anglophones. Le client, lui, ne voit pas le problème : « l’IA parle toutes les langues, non ? »
Oui et non. Un chatbot RAG n’est pas un modèle, c’est une chaîne. La question traverse trois maillons avant de devenir une réponse, et chacun réagit différemment au changement de langue. Le premier s’en sort mieux qu’on ne le croit. Le deuxième est celui que presque tout le monde oublie. Le troisième est celui qui vous trahit en production, devant le visiteur.
Le pipeline, pour savoir de quoi on parle
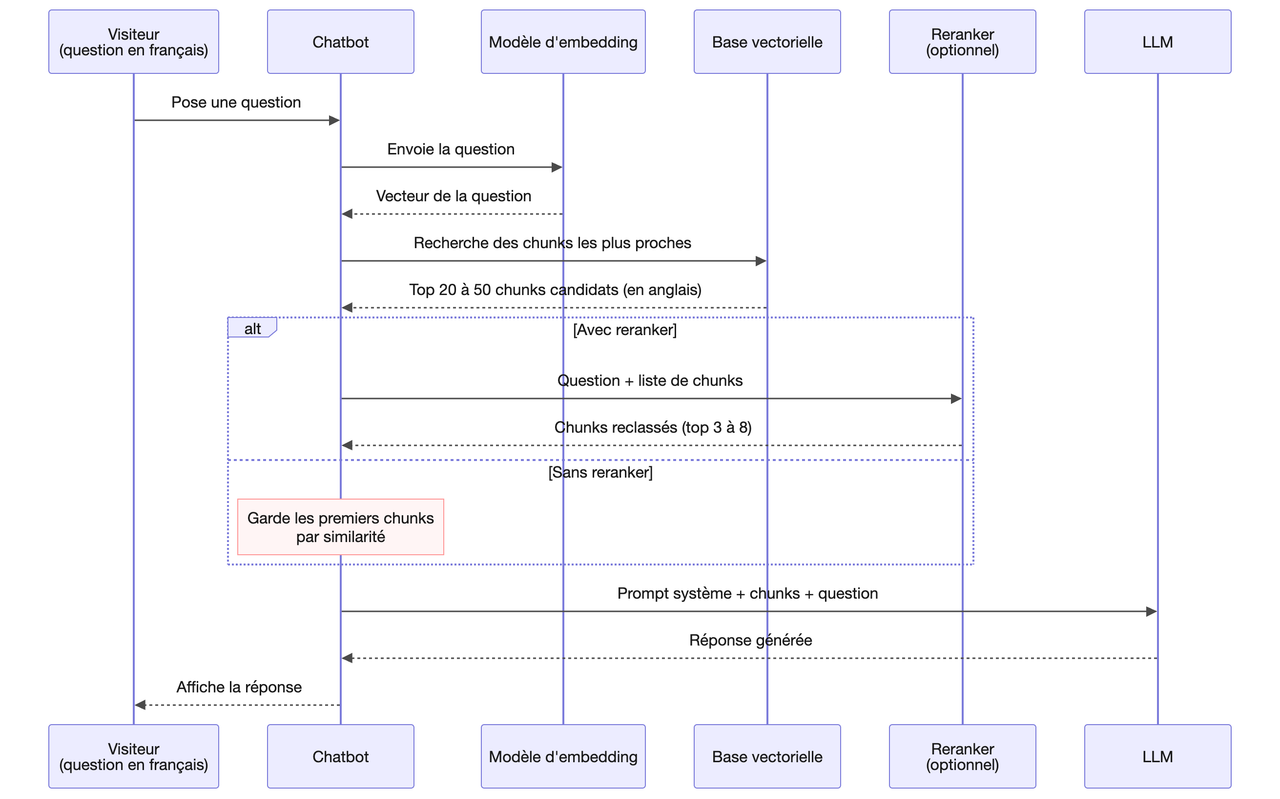
Peu importe la solution logicielle : la mécanique est la même partout.
sequenceDiagram
    participant V as Visiteur<br/>(question en français)
    participant C as Chatbot
    participant E as Modèle d'embedding
    participant B as Base vectorielle
    participant R as Reranker<br/>(optionnel)
    participant L as LLM

    V->>C: Pose une question
    C->>E: Envoie la question
    E-->>C: Vecteur de la question

    C->>B: Recherche des chunks les plus proches
    B-->>C: Top 20 à 50 chunks candidats (en anglais)

    alt Avec reranker
        C->>R: Question + liste de chunks
        R-->>C: Chunks reclassés (top 3 à 8)
    else Sans reranker
        Note over C: Garde les premiers chunks<br/>par similarité
    end

    C->>L: Prompt système + chunks + question
    L-->>C: Réponse générée
    C-->>V: Affiche la réponse
Langage du code : HTML, XML (xml)
Trois verbes résument ces étapes : retrouver, trier, répondre. Le changement de langue les met à l’épreuve une par une.
Retrouver : l’embedding tient mieux qu’on ne le craint
La bonne nouvelle d’abord. Avec un modèle d’embedding moderne et multilingue, une question française posée sur un corpus anglais remonte globalement les bons passages.
La raison tient à ce qu’un embedding encode. Il ne compare pas des mots, il place des significations dans un espace : « délai de livraison » et « shipping time » ne partagent aucune lettre utile, mais ils désignent la même chose et atterrissent au même endroit. Encore faut-il que le modèle ait été entraîné pour cela. C’est le cas de voyage-3-large, que son éditeur présente comme un modèle généraliste et multilingue, évalué notamment sur des jeux de données multilingues. La génération voyage-3 a d’ailleurs été testée sur 26 langues.
J’avais déjà croisé ce phénomène en indexant une documentation technique allemande que j’interrogeais en français : j’avais choisi de garder l’allemand plutôt que de traduire, précisément parce que l’embedding faisait le pont entre les deux langues.
Trois nuances, pour rester honnête :
- Le couple français-anglais est le cas favorable : deux langues proches, massivement représentées dans les données d’entraînement. Français-japonais ou anglais-arabe ne se comporteront pas aussi bien.
- La recherche croisée reste en général un peu moins bonne qu’une recherche dans une seule langue. La dégradation est souvent modérée, mais elle existe, et elle frappe d’abord les questions courtes et ambiguës.
- Un modèle d’embedding entraîné uniquement sur l’anglais ne fait pas ce pont du tout. Vérifiez la fiche de votre modèle avant d’accuser le reste de la chaîne.
Un piège supplémentaire guette ceux qui ont mis en place une recherche hybride. La partie lexicale, BM25 et ses cousins, compare des mots : face à une question française et un corpus anglais, elle ne trouve rien, hormis les noms propres, les références produit et les termes techniques restés en anglais. Dans ce scénario, tout le poids de la recherche repose sur le vecteur. Raison de plus pour soigner l’étape suivante.
Trier : pourquoi le reranker compte double
C’est le maillon que j’avais le moins traité jusqu’ici, et c’est celui qui change le plus la donne.
J’ai décrit le reranking dans mon guide du RAG : on récupère large, vingt à cinquante passages, puis un second modèle les reclasse pour n’en garder qu’une poignée. Ce que je n’avais pas dit, c’est pourquoi ce second passage vaut encore plus quand les langues diffèrent.
Tout tient à la manière dont les deux étapes travaillent. L’embedding encode la question d’un côté, chaque passage de l’autre, séparément. La question française et le passage anglais ne se rencontrent jamais : on compare deux résumés géométriques, calculés à des moments différents. C’est exactement là que se loge la perte de qualité du cross-lingue, car le moindre défaut d’alignement entre les langues décale le classement.
Le reranker, lui, fonctionne autrement. La documentation de Voyage le formule ainsi : ce sont des cross-encodeurs, qui traitent conjointement la paire question-document. Il lit la question française et le passage anglais ensemble, dans le même passage du modèle, et juge directement si l’un répond à l’autre. Il ne dépend plus de la géométrie d’un espace vectoriel : il fait ce que ferait un lecteur bilingue.
Concrètement, la recherche vectorielle ramène les bons passages, mais dans le désordre : le meilleur est souvent en huitième ou en quinzième position, derrière des passages vaguement apparentés. Sans reranker, vous envoyez les cinq premiers au LLM et le bon n’y est pas. Avec, il remonte en tête.
Trois règles pour que cela fonctionne.
Le reranker doit lui-même être multilingue. C’est le piège principal. Beaucoup de tutoriels branchent par réflexe un petit cross-encodeur de la famille ms-marco, parce qu’il est gratuit et tourne sur un processeur. Or ce modèle ne comprend que l’anglais : devant une question française, il classe au hasard et dégrade ce que l’embedding avait bien fait. Les options sérieuses existent : rerank-2.5 chez Voyage, annoncé avec prise en charge multilingue, les variantes multilingues de Cohere, ou bge-reranker-v2-m3 si vous hébergez vous-même.
Élargissez le filet. Un reranker ne peut reclasser que ce qu’on lui donne. Si le bon passage n’est pas dans les candidats, il est perdu. En cross-lingue, où le premier classement est plus bruité, je monte à cinquante candidats, voire cent, au lieu de vingt.
Vérifiez que votre outil le permet. Toutes les solutions de chatbot clés en main ne proposent pas encore de brancher un reranker. C’est un critère de choix que j’aurais dû ajouter à ma grille de décision pour les chatbots de sites clients : sur un site multilingue, une solution sans reranking plafonne plus bas que les autres, quel que soit le modèle derrière.
Répondre : quand le prompt impose sa langue
Les bons passages sont retrouvés et triés. Il reste à répondre, et c’est ici que survient la panne la plus visible : le visiteur écrit en français, le chatbot lui répond en anglais.
Le mécanisme est simple. Le LLM ne réagit pas seulement à la question, il réagit à tout ce qu’il a sous les yeux. Faites le compte : un prompt système de deux mille mots en anglais, cinq passages de documentation en anglais, et au bout, une question de huit mots en français. La langue du visiteur représente une fraction infime du contexte. Le modèle suit la pente.
Le phénomène s’aggrave dans trois cas : les modèles rapides et économiques qu’on utilise justement pour les chatbots, les questions courtes (« Prix ? », « Garantie », un nom de produit seul), et les questions truffées de termes techniques anglais, que le modèle prend pour de l’anglais. Il existe aussi dans l’autre sens : un long prompt système rédigé en français fera répondre en français à un visiteur anglophone.
La parade évidente, une phrase « réponds dans la langue de l’utilisateur » quelque part dans le prompt système, ne suffit pas toujours. Noyée au milieu de deux mille mots d’instructions, elle pèse peu face à la masse du reste. Voici ce qui fonctionne, du plus efficace au plus simple :
- Rappeler la consigne au plus près de la question. Dans le gabarit du message envoyé au modèle, après les passages, juste avant la question : « Question du visiteur, à laquelle tu réponds dans la même langue ». Le modèle accorde plus de poids à ce qui est proche et récent.
- Détecter la langue et l’imposer explicitement. Une bibliothèque de détection, ou la langue active du site, permet d’injecter « Réponds en français ». Une consigne absolue vaut mieux qu’une consigne relative.
- Étiqueter les passages comme matériau source. « Les documents ci-dessous peuvent être en anglais. Ne reprends pas leur langue, traduis ce que tu en utilises, en conservant les noms de produits et les termes techniques. » Le modèle comprend que la langue des sources n’est pas celle de la réponse.
- Placer la consigne de langue à la fin du prompt système, pas au début. C’est le minimum si vous ne pouvez rien faire d’autre.
Sur un site bilingue, où le même chatbot sert deux publics, seules les deux premières tiennent vraiment.
Les alternatives, et ce qu’elles coûtent
Traduire la question avant la recherche. Un petit modèle traduit la question en anglais, puis la recherche se fait dans une seule langue. C’est efficace et peu coûteux, mais cela ajoute un appel et quelques centaines de millisecondes, et une traduction maladroite d’un terme technique peut envoyer la recherche dans le décor. La version prudente consiste à chercher avec la question d’origine et avec sa traduction, puis à laisser le reranker départager.
Traduire le corpus. C’est la solution lourde : deux bases à maintenir, des coûts d’indexation doublés, et une traduction qui fige une interprétation. Elle ne se justifie que si la majorité des visiteurs parle l’autre langue.
Changer de modèle d’embedding. Si le volume de questions croisées devient important, des modèles plus spécifiquement multilingues comme BGE-M3 méritent un essai, avec l’avantage de pouvoir être hébergés chez soi. Mais attention : changer de modèle d’embedding oblige à tout réindexer. Ce n’est pas une décision qu’on prend pour gagner deux points.
Ce qu’on m’opposera
« Les fenêtres de contexte sont devenues gigantesques, il suffit d’envoyer cinquante passages au LLM. » On peut. On paie alors cinquante passages à chaque question, on ralentit la réponse, et on noie le modèle dans du texte étranger à la question, ce qui aggrave précisément la dérive de langue décrite plus haut. Le reranker coûte une fraction de cela.
« Un reranker ajoute de la latence. » Oui, de l’ordre de quelques centaines de millisecondes avec une API. Sur un chatbot dont la réponse met deux à trois secondes à s’afficher, personne ne le remarque. Une mauvaise réponse, si.
« Mon chatbot répond correctement en français, je n’ai pas ce problème. » Peut-être. L’avez-vous mesuré ? Une réponse fluide en français ne prouve pas que le bon passage a été retrouvé : le modèle sait très bien broder autour d’un passage médiocre.
Mon avis
Le multilingue est la promesse la plus mal vendue du chatbot IA. On affirme au client que « ça marche dans toutes les langues », on teste trois questions en anglais, et on met en production. Ce qui marche dans toutes les langues, c’est le LLM. La chaîne qui l’alimente, elle, a été pensée dans une seule.
Ma grille tient en trois lignes. Un embedding multilingue, sinon rien ne remonte. Un reranker multilingue dès que les questions croisées dépassent l’anecdote, parce que c’est le maillon au meilleur rapport gain sur effort de toute la chaîne. Une consigne de langue rappelée au plus près de la question, parce que c’est la seule panne que le visiteur voit de ses yeux.
Et avant tout cela, une vérification que presque personne ne fait : constituer vingt questions réelles en français, les poser à son corpus anglais, et regarder à quelle position remonte le bon passage, avec et sans reranker. J’ai expliqué comment bâtir une évaluation qui ne se raconte pas d’histoires. Dix minutes de mesure valent mieux que toutes les fiches produit, la mienne comprise.