Le RAG expliqué comme personne ne le fait : du concept au pipeline qui fonctionne
Ce que vous allez apprendre, et pourquoi la plupart des explications du RAG passent à côté
Vous avez probablement déjà vécu cette scène. Vous posez une question précise à un LLM (Claude, Gemini, ChatGPT) en espérant une réponse tirée de vos documents. Le modèle vous répond avec assurance, dans un français impeccable, en citant des faits qui n’existent pas. Pas une erreur de nuance. Une invention pure, livrée avec le même aplomb qu’une vérité vérifiée.
Ce problème porte un nom : l’hallucination. Et la solution architecturale qui s’est imposée pour le résoudre en porte un autre : le RAG, pour Retrieval-Augmented Generation, ou Génération Augmentée par la Récupération, si vous préférez le français.
Le concept circule partout. Les articles de vulgarisation le résument en une phrase : « on donne des documents au modèle pour qu’il réponde mieux ». C’est factuellement correct. C’est aussi spectaculairement insuffisant. Parce que le RAG n’est pas un bouton qu’on active. C’est un pipeline : une chaîne de décisions techniques où chaque maillon (comment découper vos documents, comment les transformer en vecteurs, comment les stocker, comment les retrouver, comment les injecter dans le prompt) détermine la qualité du résultat final. Et la majorité de ces décisions sont invisibles pour l’utilisateur.
Si vous avez lu mon article sur les vecteurs, de Newton aux embeddings de ChatGPT, vous avez déjà l’intuition fondamentale : un texte peut être projeté dans un espace mathématique où la proximité géométrique reflète la proximité de sens. Le RAG est la mise en application industrielle de cette intuition. C’est le système qui transforme « ces deux textes sont proches dans l’espace vectoriel » en « voici la réponse à votre question, avec les sources ».
Cet article couvre la mécanique complète du pipeline RAG (du chunking au re-ranking) avec les données des benchmarks 2026, les outils concrets (NotebookLM, ChromaDB, LangChain), la taxonomie des approches (RAG fermé, ouvert, hybride), et les pièges que les débutants rencontrent systématiquement. Le tout adossé aux études FloTorch, HiCBench et Firecrawl publiées ces dernières semaines, et à l’expérience accumulée depuis ma propre stack IA.
Si vous ne retenez qu’une chose de cette introduction, que ce soit celle-ci : le RAG n’est pas un concept : c’est une discipline d’ingénierie. Et comme toute discipline, elle a ses règles, ses anti-patterns, et ses raccourcis qui coûtent cher.
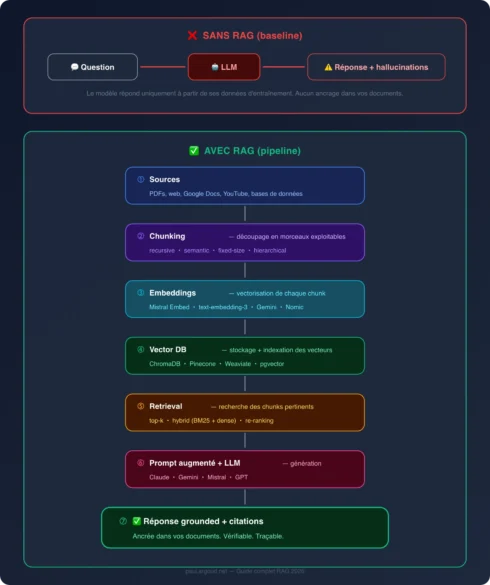
Avant d’entrer dans les détails, voici le flux complet d’un système RAG. Chaque étape est une décision technique qui affecte toutes les suivantes.
La différence fondamentale entre les deux schémas tient en un mot : le grounding (l’ancrage). Sans RAG, le modèle puise dans sa mémoire d’entraînement, qui est figée, incomplète, et parfois fausse. Avec RAG, il puise dans vos documents, en temps réel, et peut citer ses sources.
Chaque étape du pipeline mérite qu’on s’y arrête. Commençons par celle qui détermine tout le reste.
Le chunking : la décision la plus sous-estimée du pipeline
Les stratégies de chunking en 2026
Un LLM ne sait pas chercher dans un document de 200 pages, il sait lire. Le chunking résout ce problème en découpant les documents en morceaux, en les indexant individuellement, et en ne présentant au modèle que les morceaux pertinents. C’est le premier geste du pipeline, et celui que les débutants bâclent le plus.
Fixed-size (taille fixe). La méthode la plus simple : on découpe tous les X tokens, point. C’est rapide à implémenter et prévisible. C’est aussi la méthode qui produit les pires résultats dans la majorité des cas, parce qu’elle coupe aveuglément au milieu des phrases, des paragraphes, des idées. Un chunk qui commence par « …de la directive européenne » et se termine par « le rapport indique que… » ne porte aucun sens exploitable.
Recursive character splitting. La méthode qui domine les benchmarks. Le principe : on essaie d’abord de couper par paragraphe, puis par phrase, puis par mot, en cascade. Le résultat respecte les frontières naturelles du texte. L’étude FloTorch de février 2026 (qui a comparé sept stratégies de chunking avec des budgets de contexte égaux et des métriques standardisées) place le recursive splitting à 512 tokens en tête sur les scores d’accuracy et de retrieval F1. C’est la stratégie par défaut de LangChain, et c’est celle par laquelle vous devriez commencer.
Semantic chunking. On utilise un modèle d’embeddings pour détecter les ruptures de sens et couper là où la similarité sémantique chute. L’idée est élégante. La réalité est plus nuancée : l’étude FloTorch montre que le semantic chunking est souvent surpassé par le recursive splitting simple, tout en coûtant significativement plus cher (chaque coupure nécessite un appel d’embedding). C’est le paradoxe de 2026 : la méthode la plus sophistiquée n’est pas toujours la meilleure.
Hierarchical chunking. L’approche la plus prometteuse. On indexe le même document à plusieurs niveaux de granularité (paragraphes, sections, pages) et on utilise des relations parent-enfant pour naviguer entre les niveaux. Le benchmark HiCBench (septembre 2025, arXiv) montre des gains de 18 à 25 % sur la qualité du retrieval par rapport aux approches plates. L’inconvénient : la complexité d’implémentation est réelle, et les outils de production ne sont pas encore tous matures.
⚠️ Erreur fréquente : le chunking purement fixe sans overlap
C’est l’erreur n°1 des débutants. Un chunking fixe à 512 tokens sans overlap produit des coupures au milieu des phrases, une perte de contexte entre chunks adjacents, et un retrieval médiocre. La solution minimale : passez à recursive splitting avec 10 à 20 % d’overlap. Les benchmarks Firecrawl (octobre 2025, données NVIDIA/Chroma) montrent que 15 % d’overlap améliore le recall de 9 % par rapport à zéro overlap. C’est un gain gratuit : il suffit de changer un paramètre.
L’insight contre-intuitif de 2026
AI21 Labs a publié en janvier 2026 une étude qui remet en question l’idée même d’un « bon » chunk size. Leur constat : la taille de chunk optimale dépend de la requête, pas du document. Une question factuelle précise (« Quel est le taux de TVA applicable ? ») bénéficie de petits chunks (100–200 tokens). Une question de synthèse (« Résumez les implications fiscales de ce contrat ») bénéficie de grands chunks (500–1 000 tokens). En indexant le même corpus à plusieurs tailles et en agrégeant les résultats avec Reciprocal Rank Fusion, ils obtiennent des gains de 1 à 37 % selon les benchmarks, sans ré-entraîner aucun modèle.
La conclusion pratique : si vous avez des requêtes de nature variée, envisagez une indexation multi-échelle plutôt qu’un chunk size unique. Et si vous débutez, commencez par 512 tokens en recursive splitting avec 15 % d’overlap, c’est le baseline qui fonctionne le mieux dans le plus grand nombre de cas.
⏩ Attention : même avec un excellent chunking, à partir de 10 000–50 000 chunks, un nouveau problème apparaît : le retrieval commence à retourner du bruit sémantiquement indifférencié. C’est le semantic collapse, sujet de mon prochain article.
Embeddings 2026 : quel modèle choisir (et surtout ne pas changer)
Une fois vos documents découpés, il faut les rendre cherchables. C’est le rôle des embeddings, la vectorisation dont j’ai détaillé l’histoire et l’intuition dans un article précédent. Chaque chunk est transformé en une liste de nombres (768 à 3 072 dimensions) qui encode son sens dans un espace mathématique. Deux chunks sur le même sujet produisent des vecteurs proches. Cette distance est mesurable, et c’est elle qui permet le retrieval.
Les modèles d’embedding en 2026
Le choix du modèle d’embedding est moins critique que la stratégie de chunking, mais il n’est pas anodin :
L’erreur classique : changer de modèle d’embedding après avoir indexé vos documents. Les vecteurs de modèles différents ne sont pas comparables : changer signifie ré-indexer l’intégralité du corpus. Choisissez bien au départ.
Vector DB 2026 : ChromaDB, Pinecone, Weaviate, pgvector, lequel choisir ?
Avant d’entrer dans le comparatif, une précision s’impose : une base vectorielle n’est pas une condition nécessaire au RAG. C’est le mécanisme de retrieval le plus adapté aux corpus textuels non structurés, mais sur des données structurées, une requête SQL fait le même travail. Sur un domaine avec un vocabulaire précis et stable (juridique, médical, réglementaire), BM25 seul surpasse souvent la recherche vectorielle. Et un RAG ouvert comme Perplexity ou Claude avec recherche web ne touche aucune base vectorielle : il récupère des pages en temps réel. Ce qui définit le RAG, c’est la boucle retrieve → inject → generate, pas la technologie qui assure le retrieval.
Une base relationnelle classique est optimisée pour les requêtes exactes (« donne-moi les utilisateurs nommés Dupont »). Une base vectorielle est optimisée pour les requêtes de similarité (« donne-moi les 10 chunks les plus proches de cette question »). La recherche de voisins les plus proches dans un espace à 1 024 dimensions utilise des algorithmes d’indexation spécialisés (principalement HNSW) qui trouvent les voisins approximatifs en temps quasi-constant, même avec des millions de vecteurs.
ChromaDB : l’entrée en matière par excellence. Open source (Apache 2.0), installation en une ligne (pip install chromadb), fonctionnement en mémoire pour le prototypage, persistance sur disque pour la production locale. Le cœur a été réécrit en Rust en 2025, avec des gains de performance jusqu’à 4x. En février 2026, ChromaDB v1.5 supporte nativement la recherche vectorielle, le full-text search (BM25 et SPLADE), la recherche regex, le metadata filtering, et les embeddings multi-modaux (texte + image via OpenCLIP). Son service cloud (Chroma Cloud) permet de passer en production sans gérer d’infrastructure. C’est l’outil que je recommande pour débuter : un pipeline RAG fonctionnel en moins de 30 lignes de Python.
Les autres acteurs à connaître :
Solution
Type
Recherche hybride
Idéal pour
Pinecone
Fully managed, propriétaire
Oui
Production sans ops, scaling automatique
Weaviate
Open source, self-hosted ou cloud
Oui (BM25 natif)
Enterprise, filtrage complexe
pgvector
Extension PostgreSQL
Non (vecteur seul)
Intégration dans un stack PostgreSQL existant
Chroma Cloud
Managed ChromaDB
Oui (BM25, SPLADE)
Transition prototypage → production
Quel choix pour quel cas d’usage ? Prototypage : ChromaDB local. Production sans gestion d’infrastructure : Pinecone ou Chroma Cloud. Stack PostgreSQL existant : pgvector. Enterprise avec recherche hybride : Weaviate ou ChromaDB.
Retrieval : top-k, hybride, re-ranking, les leviers qui changent tout
Le retrieval est l’étape où le système cherche les chunks pertinents pour la question posée. La méthode la plus simple (le top-k) transforme la question en vecteur et retourne les k plus proches. C’est un bon point de départ, mais deux problèmes se posent systématiquement en production.
Problème 1 : la recherche sémantique rate les correspondances lexicales. Si votre question contient un identifiant technique (« erreur ERR-4012 ») ou un nom propre, la recherche vectorielle peut ne pas retrouver le chunk qui contient cette chaîne exacte, parce que les embeddings capturent le sens et non les mots. C’est là qu’intervient la recherche hybride.
Problème 2 : le top-k retourne du bruit. Parmi les 10 ou 20 chunks les plus proches, certains sont pertinents, d’autres sont proches dans l’espace vectoriel mais pas utiles pour la question. Sans filtrage supplémentaire, ce bruit se retrouve dans le prompt du LLM et dégrade la qualité de la réponse.
La recherche hybride : le meilleur des deux mondes
La recherche hybride combine la recherche vectorielle (dense retrieval, basée sur les embeddings) et la recherche par mots-clés (sparse retrieval, typiquement BM25). BM25 est l’algorithme classique des moteurs de recherche : il retrouve les documents qui contiennent les mêmes termes que la requête, pondérés par leur fréquence et leur rareté.
En combinant les deux, le sens (vecteurs) et les mots (BM25), vous obtenez un retrieval nettement plus robuste. ChromaDB supporte cette approche nativement depuis 2025, avec un support first-class pour les vecteurs BM25 et SPLADE aux côtés des vecteurs denses.
Le re-ranking : l’étape que tout le monde oublie
C’est ici que se situe l’insight le plus important de cet article sur le pipeline RAG, et c’est l’étape que la majorité des implémentations négligent.
Le re-ranking consiste à prendre les résultats du retrieval (typiquement les 20 à 50 chunks les plus pertinents) et à les re-classer avec un modèle plus puissant (un cross-encoder ou un LLM utilisé comme juge) pour ne garder que les 3 à 5 meilleurs. Le cross-encoder, contrairement à la recherche vectorielle qui compare des vecteurs pré-calculés indépendamment, analyse la paire (question, chunk) ensemble, ce qui lui permet de capturer des relations de pertinence beaucoup plus fines.
L’étude FloTorch de février 2026 est catégorique sur ce point : investir dans la complexité du re-ranking produit des gains mesurables, là où investir dans la complexité du chunking produit souvent des rendements décroissants. En d’autres termes, mieux vaut un chunking simple avec un bon re-ranker qu’un chunking sophistiqué sans re-ranking. C’est exactement l’inverse de ce que l’intuition suggère, et c’est pour cette raison que tant de pipelines sous-performent.
RAG fermé vs RAG ouvert vs RAG hybride : la taxonomie 2026
La distinction la plus structurante en 2026 n’est pas technique : elle est architecturale. Il s’agit de savoir d’où viennent les données que le système utilise pour répondre.
RAG fermé : tout est groundé sur vos sources
Le RAG fermé n’a accès qu’aux documents que vous lui fournissez explicitement. Pas d’accès web, pas de mémoire d’entraînement comme source de vérité : uniquement vos fichiers. Si l’information n’est pas dans vos sources, le système le dit (ou devrait le dire).
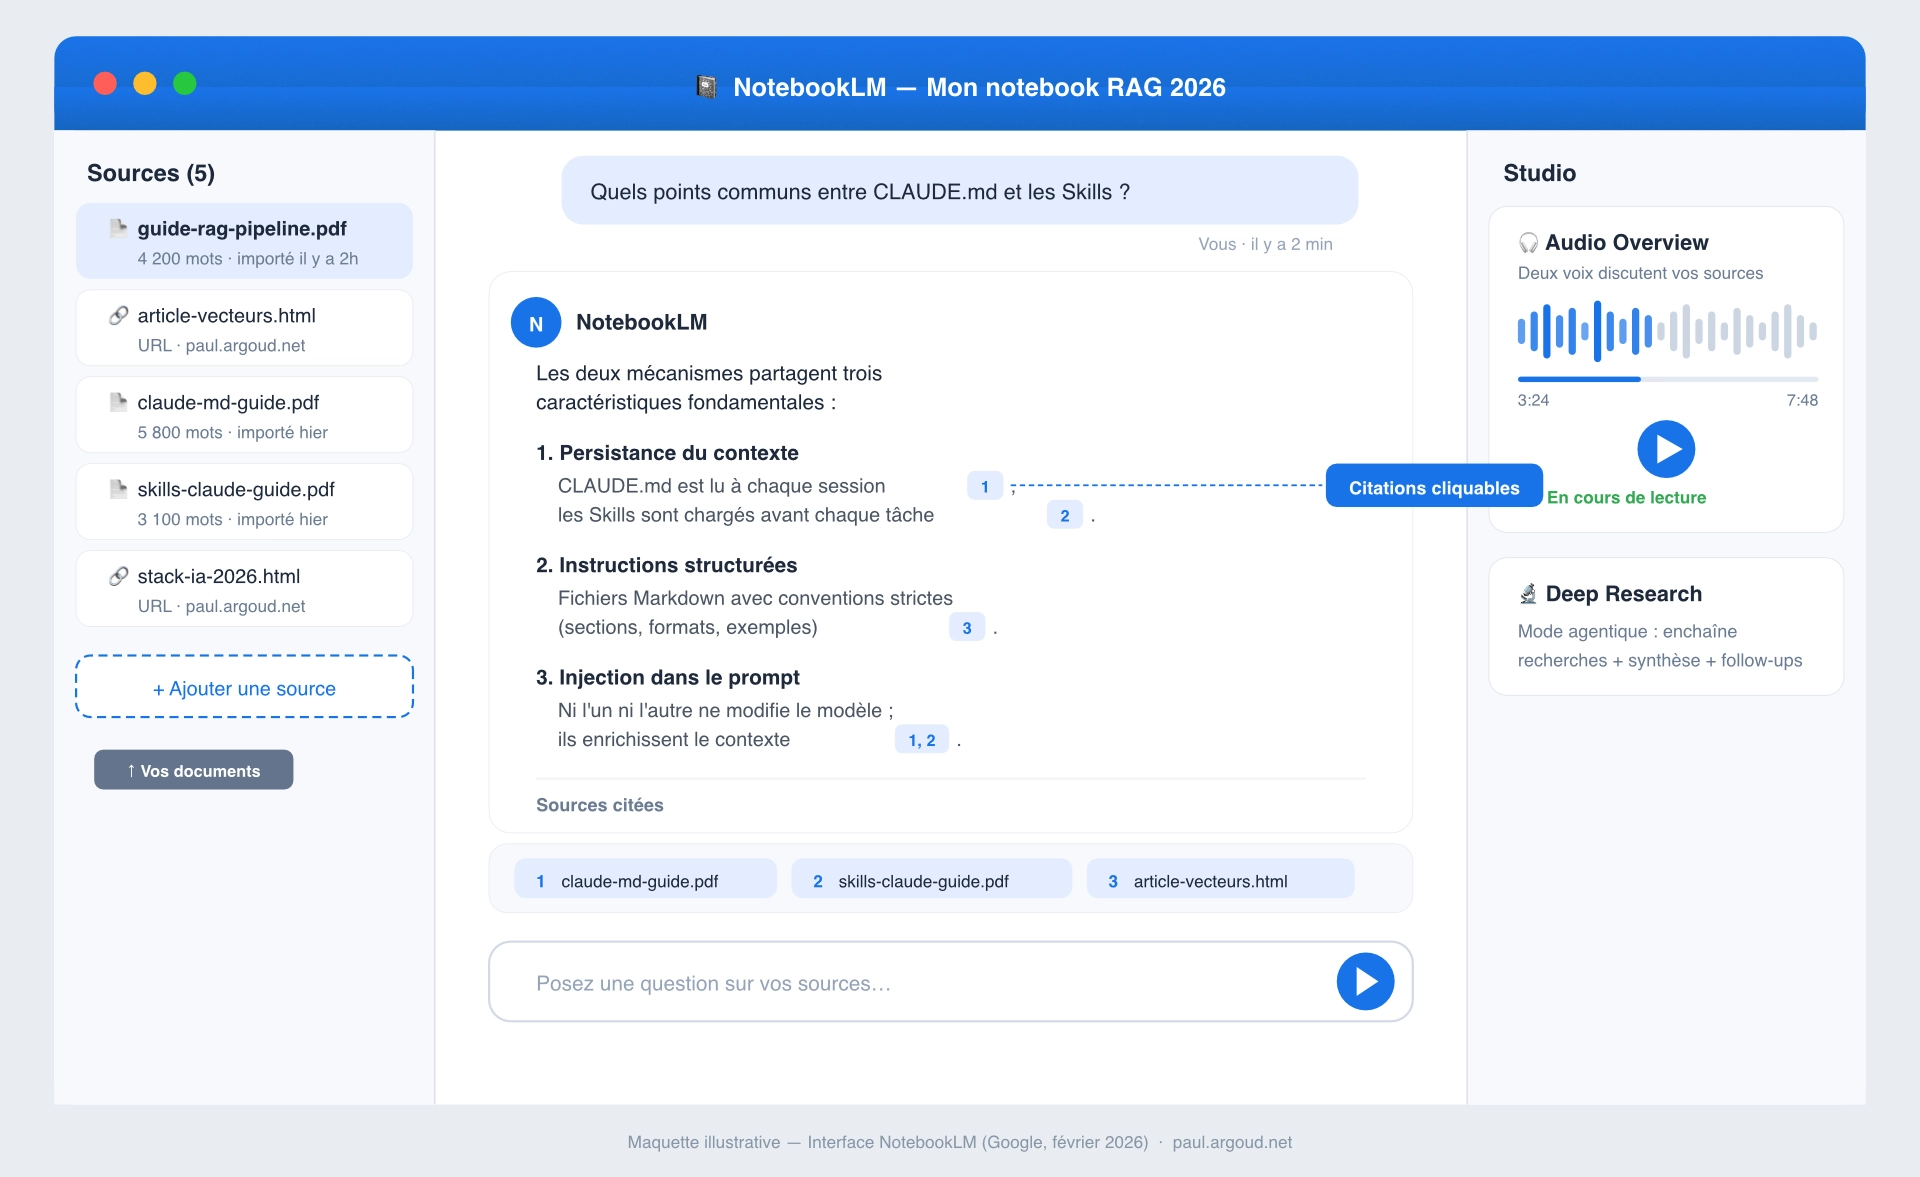
L’archétype du RAG fermé en 2026, c’est NotebookLM de Google. Vous uploadez vos documents (PDFs, Google Docs, pages web, vidéos YouTube, Google Sheets), et NotebookLM répond exclusivement à partir de ces sources, avec des citations cliquables qui renvoient au passage exact du document d’origine.
Les avantages sont considérables : zéro risque d’hallucination externe (le modèle ne peut pas inventer ce qui n’est pas dans vos sources), confidentialité maîtrisée (vos données ne sortent pas du périmètre défini), et traçabilité complète (chaque affirmation est sourcée). Les limites sont le corollaire direct : si vos sources sont incomplètes, le système est « aveugle » sur les sujets non couverts.
Cas d’usage idéaux : recherche académique, analyse de contrats, revue de littérature, notes de réunion, formation sur un corpus interne.
RAG ouvert : retrieval sur le web et au-delà
Le RAG ouvert va chercher l’information sur le web ou dans des bases de données externes, en plus (ou à la place) de vos documents personnels. Perplexity est l’exemple le plus visible : chaque réponse est construite à partir de pages web récupérées en temps réel, avec des citations vers les sources.
Claude avec la recherche web activée, Gemini en mode standard, et ChatGPT avec browsing fonctionnent sur ce principe. La puissance est évidente : accès à l’actualité, couverture quasi illimitée, capacité à répondre à des questions sur des sujets que vous n’avez pas documentés.
Les risques sont proportionnels : bruit dans les résultats (le web est plein de contenus de qualité variable), biais de source (le modèle peut privilégier des sources populaires plutôt que pertinentes), et hallucinations quand le retrieval ramène des informations contradictoires ou hors sujet.
RAG hybride : le meilleur des deux mondes (en théorie)
Le RAG hybride combine vos sources privées et des sources externes, avec une hiérarchie de confiance. Le système vérifie d’abord dans vos documents, puis complète avec le web si nécessaire.
NotebookLM a franchi ce pas en novembre 2025 avec l’intégration de Deep Research : le système peut désormais chercher au-delà de vos sources uploadées, mais uniquement si vous l’autorisez explicitement, et en gardant le grounding sur vos documents comme priorité. En décembre 2025, Google a poussé l’intégration plus loin en permettant d’attacher un notebook NotebookLM directement dans un chat Gemini : vous combinez ainsi la rigueur du RAG fermé (votre base documentaire) avec la puissance du RAG ouvert (le web via Gemini), le tout dans une seule interface.
C’est ce positionnement hybride qui fait de NotebookLM le meilleur outil pédagogique pour comprendre le RAG en 2026 : il vous montre concrètement la différence entre une réponse groundée sur vos sources et une réponse enrichie par le web.
RAG fermé
RAG ouvert
RAG hybride
Sources de données
Uniquement vos documents uploadés
Web + bases externes
Vos documents + web (avec hiérarchie)
Risque d’hallucination
Très faible (limité à vos sources)
Modéré à élevé (dépend du retrieval)
Faible si bien configuré
Couverture
Limitée à vos sources
Quasi illimitée
Large, avec priorité au corpus privé
Traçabilité
Excellente (citations exactes)
Variable (dépend de l’outil)
Bonne (distinction source privée/web)
Confidentialité
Maximale
Faible (données transitent sur le web)
Configurable
Exemples 2026
NotebookLM (mode standard)
Perplexity, Gemini standard
NotebookLM + Deep Research, Gemini + Notebook
Cas d’usage idéal
Recherche, contrats, formation, notes
Actualité, veille, recherche large
Projets combinant corpus interne et veille
🔒 Confidentialité : ce que le RAG expose (et ce qu’il n’expose pas)
Connecter vos documents à un LLM via RAG ne rend pas leur contenu accessible aux autres utilisateurs du modèle. Le RAG injecte vos chunks dans votre prompt : c’est du contexte de session, pas du fine-tuning. En revanche, le fournisseur pourrait-il utiliser vos données pour entraîner ses futurs modèles ? Les plans payants/enterprise offrent généralement des engagements contractuels contre cela, mais les plans gratuits ont des clauses plus ambiguës, et les politiques évoluent. Le seul moyen d’éliminer ce risque : héberger le modèle localement (Ollama, LLM open source). Pour des documents sensibles : vérifiez les CGU, privilégiez les plans payants, et considérez l’hébergement local si le niveau de confidentialité l’exige.
NotebookLM : le RAG en pratique
Pourquoi commencer par NotebookLM
Si vous n’avez jamais manipulé un système RAG, NotebookLM est l’endroit par lequel commencer. Pas parce que c’est le plus puissant (un pipeline custom avec ChromaDB vous donnera plus de contrôle) mais parce qu’il rend le RAG visible. Vous voyez les sources citées, vous voyez quand le modèle ne trouve pas l’information, vous voyez la différence entre une réponse groundée et une réponse inventée.
Walkthrough : de l’upload à l’insight
Voici un cas d’usage concret. Je vais utiliser NotebookLM pour analyser mes propres articles de blog sur l’IA, un corpus que je connais intimement, ce qui me permet de vérifier la qualité des réponses.
Étape 1 : Créer un notebook et importer les sources. Rendez-vous sur notebooklm.google.com. Créez un nouveau notebook. Uploadez vos sources : PDFs, Google Docs, pages web (par URL), vidéos YouTube, ou même Google Sheets. Pour mon test : j’importe mes cinq derniers articles techniques par URL. NotebookLM supporte jusqu’à 50 sources par notebook en gratuit, 300 en Pro (Google AI Pro, 19,99 $/mois) et 600 en Ultra, un volume suffisant pour la plupart des projets de recherche.
Étape 2 : Explorer avec le chat. Une fois les sources chargées, posez une question transversale : quelque chose qui nécessite de croiser plusieurs documents. Par exemple : « Quels sont les points communs entre la gestion de la mémoire dans CLAUDE.md et le chargement progressif des Skills ? » NotebookLM va chercher dans les articles pertinents, synthétiser, et citer les passages exacts. Chaque citation est cliquable : vous pouvez vérifier que le modèle n’invente rien.
Étape 3 : Générer un Audio Overview (le podcast). C’est la fonctionnalité signature de NotebookLM. L’outil génère un « podcast » de 10 à 15 minutes où deux voix synthétiques discutent de vos sources avec un naturel troublant. Ce n’est pas un gadget : c’est un outil d’apprentissage redoutablement efficace. Écouter ses propres documents résumés et discutés par une IA vous fait découvrir des connexions que vous n’aviez pas vues à l’écrit. Le mode interactif, disponible dans le format Deep Dive, vous permet même de poser des questions au podcast en cours de lecture.
Étape 4 : Activer Deep Research (le RAG hybride). Depuis novembre 2025, NotebookLM intègre Deep Research. Depuis janvier 2026, il fonctionne en mode agentique complet : le système enchaîne plusieurs recherches autonomes au-delà de vos sources, synthétise les résultats, et propose des pistes de suivi (follow-ups). Lancez une recherche approfondie sur un sujet lié à vos documents : NotebookLM ira chercher sur le web, vous ramènera un rapport structuré avec des dizaines de sources, et vous pourrez les importer dans votre notebook pour enrichir votre base.
Étape 5 : Connecter à Gemini. Depuis janvier 2026, vous pouvez attacher votre notebook directement dans un chat Gemini via le menu d’attachement. Gemini a alors accès à votre base documentaire tout en conservant ses capacités conversationnelles, Canvas, et Deep Research. C’est la combinaison la plus puissante de l’écosystème Google en 2026 : la rigueur du RAG fermé plus la flexibilité du RAG ouvert.
L’intérêt pédagogique de NotebookLM va au-delà de son utilité pratique. En l’utilisant, vous observez concrètement les phénomènes fondamentaux du RAG : comment le retrieval sélectionne les passages, comment le système gère les contradictions entre sources, et comment la qualité des sources détermine la qualité des réponses.
Les autres services managés : le RAG sans pipeline
NotebookLM n’est pas le seul. Plusieurs services proposent le RAG clé en main : Perplexity (RAG ouvert orienté recherche web, chaque réponse sourcée), Claude avec Projects d’Anthropic (uploadez des documents, Claude les utilise comme contexte : RAG fermé light avec la qualité de raisonnement de Claude), Gemini avec Google Drive (accès direct à vos fichiers, enrichi par l’intégration NotebookLM), et les solutions enterprise (Pinecone, Weaviate Cloud, Chroma Cloud : bases vectorielles managées avec pipelines d’ingestion intégrés).
La règle : si vous explorez, commencez par NotebookLM. Si vous avez besoin de contrôle, construisez avec ChromaDB. Si vous avez besoin de scale sans ops, passez à un cloud managé.
ChromaDB : construire votre propre pipeline RAG
NotebookLM est un outil fermé : vous ne contrôlez ni le chunking, ni les embeddings, ni le retrieval, ni le prompt. Pour un chatbot sur votre documentation produit, un assistant métier, ou un pipeline d’extraction, vous avez besoin de contrôler chaque paramètre. C’est là qu’intervient ChromaDB, et plus largement les frameworks comme LangChain et LlamaIndex.
Un pipeline RAG minimal en Python
Voici un pipeline RAG fonctionnel en Python avec ChromaDB. Ce n’est pas un jouet : c’est la structure que vous pouvez étendre pour un cas d’usage réel.
import chromadb
from chromadb.utils import embedding_functions
# 1. Initialiser ChromaDB (en mémoire pour le prototypage)
client = chromadb.Client()
# Ou avec persistance sur disque :# client = chromadb.PersistentClient(path="./chroma_db")# 2. Choisir un modèle d'embedding# Par défaut : all-MiniLM-L6-v2 (gratuit, local)# Pour la production, considérez OpenAI ou Mistral Embed
embedding_fn = embedding_functions.DefaultEmbeddingFunction()
# 3. Créer une collection (= un index)
collection = client.create_collection(
name="mes_documents",
embedding_function=embedding_fn
)
# 4. Ajouter des chunks avec métadonnées# En production, ces chunks viennent de votre pipeline de chunking
collection.add(
documents=[
"Le RAG permet d'ancrer les réponses d'un LLM dans des documents fournis.",
"Le chunking recursive respecte les frontières naturelles du texte.",
"ChromaDB supporte la recherche vectorielle et le full-text search.",
"Le re-ranking avec un cross-encoder améliore la précision du retrieval.",
],
metadatas=[
{"source": "intro.pdf", "section": "définition"},
{"source": "chunking.pdf", "section": "stratégies"},
{"source": "chromadb.pdf", "section": "fonctionnalités"},
{"source": "retrieval.pdf", "section": "optimisation"},
],
ids=["chunk_1", "chunk_2", "chunk_3", "chunk_4"]
)
# 5. Rechercher les chunks pertinents pour une question
results = collection.query(
query_texts=["Comment améliorer la qualité du retrieval ?"],
n_results=3# top-k = 3
)
# 6. Les résultats contiennent les chunks, distances et métadonnéesfor doc, metadata, distance in zip(
results["documents"][0],
results["metadatas"][0],
results["distances"][0]
):
print(f"[{distance:.4f}] {metadata['source']} → {doc[:80]}...")
Langage du code :Python(python)
Ce qui se passe sous le capot : ChromaDB transforme votre question en vecteur (via le même modèle d’embedding que celui utilisé pour indexer les chunks), calcule la distance cosinus avec tous les vecteurs stockés, et retourne les n_results plus proches. Les métadonnées (source, section) permettent de filtrer les résultats : par exemple, ne chercher que dans un document spécifique ou une section donnée.
Du prototype à la production
Le code ci-dessus est un point de départ. Pour un pipeline de production, vous ajouterez :
Un vrai pipeline de chunking. LangChain fournit des chunkers pré-construits (RecursiveCharacterTextSplitter, SemanticChunker) qui gèrent l’overlap, les séparateurs personnalisés, et le respect des frontières de phrases.
Un modèle d’embedding de production. Remplacez le modèle par défaut par Mistral Embed (si corpus francophone), OpenAI text-embedding-3-large (qualité générale), ou Nomic Embed (bon rapport qualité/prix).
La recherche hybride. ChromaDB supporte BM25 nativement : activez-le pour combiner recherche sémantique et recherche par mots-clés.
Le re-ranking. Ajoutez un cross-encoder (comme cross-encoder/ms-marco-MiniLM-L-12-v2 de Sentence Transformers) ou utilisez un LLM comme juge pour re-classer les résultats du retrieval avant de les injecter dans le prompt.
Le monitoring. Suivez vos métriques de retrieval (recall, precision, MRR, nDCG) au fil du temps. Des frameworks comme RAGAS fournissent des outils d’évaluation standardisés pour les pipelines RAG.
📊 Comment évaluer son RAG ? Trois métriques essentielles
Vous ne pouvez pas améliorer ce que vous ne mesurez pas. Trois métriques couvrent l’essentiel :
Retrieval Recall@5 : sur vos 5 meilleurs chunks retournés, combien sont réellement pertinents ? Si vous êtes en dessous de 80 %, votre chunking ou votre modèle d’embedding pose problème.
Faithfulness : la réponse du LLM est-elle fidèle aux chunks injectés, ou hallucine-t-elle au-delà ? Un score bas signale un prompt mal conçu ou des chunks trop courts pour fournir assez de contexte.
Answer Relevance : la réponse finale répond-elle réellement à la question posée ? Un score bas avec un bon recall indique que le problème est côté génération, pas côté retrieval.
Des frameworks comme RAGAS et Patronus AI automatisent ces mesures. Intégrez-les dès le début, pas après le premier bug en production.
Pièges, dépannage et bonnes pratiques
Les cinq symptômes récurrents et leurs causes
« Les réponses sont hors sujet ou incomplètes. » Cause presque toujours : le chunking. Un chunking fixed-size sans overlap produit des chunks sans sens complet. Solution : recursive splitting avec 10–20 % d’overlap. Si le problème persiste, testez le semantic chunking ou augmentez à 400–600 tokens.
« Beaucoup de bruit dans les résultats. » Le retrieval ramène des chunks « proches » mais pas pertinents. Leviers : metadata filtering (filtrez par date, auteur, section avant la recherche vectorielle) et recherche hybride BM25 + dense.
« Le modèle hallucine malgré les bonnes sources. » Les chunks pertinents sont noyés parmi des chunks non pertinents dans le prompt. Solution : re-ranking avec cross-encoder ou LLM-as-judge, top-20 → top-5.
« Les coûts API explosent. » Retrieval inefficace = trop de chunks envoyés au LLM. Solution : meilleur chunking + re-ranking pré-LLM pour filtrer avant d’envoyer.
« Le contexte long est perdu. » Phénomène « lost in the middle », documenté par Stanford/Berkeley dès 2023 : les LLM traitent mieux les informations placées en début et en fin de prompt, et « oublient » ce qui est au milieu. Solution : limitez à 3–5 chunks injectés, placez les plus pertinents en début et fin de prompt, chunks de 400–600 tokens avec overlap 100–150 tokens.
Index non optimisé ou modèle d’embedding trop lourd
Batch inserts, metadata filtering en amont, embeddings compacts
P2
Checklist de validation avant mise en production
Avant de commencer :
[ ] Vous avez identifié le type de RAG adapté à votre cas (fermé, ouvert, hybride)
[ ] Vous avez un corpus de test avec des questions et des réponses attendues
[ ] Vous avez choisi un modèle d’embedding et vous ne prévoyez pas d’en changer en cours de route
Pendant la construction :
[ ] Votre chunking respecte les frontières de phrases (pas de coupures au milieu)
[ ] Vous avez un overlap de 10 à 20 % entre chunks
[ ] Vos chunks portent des métadonnées (source, date, section)
[ ] Vous testez avec plusieurs tailles de chunks si vos requêtes sont variées
[ ] Votre retrieval combine vectoriel et BM25 (recherche hybride)
[ ] Vous avez une étape de re-ranking avant l’injection dans le prompt
Après le déploiement :
[ ] Vous mesurez le recall et la precision de votre retrieval
[ ] Vous suivez le taux d’hallucination sur un échantillon de questions
[ ] Vous avez un processus de ré-indexation quand vos sources changent
[ ] Vous mesurez les coûts par requête et identifiez les optimisations possibles
Le mot de la fin
Le RAG est aujourd’hui la brique indispensable de l’IA productive. C’est ce qui transforme un LLM (brillant mais amnésique) en un assistant ancré dans vos données, capable de citer ses sources et de reconnaître les limites de son savoir. Sans RAG, un LLM est un orateur charismatique qui improvise. Avec RAG, c’est un analyste qui travaille avec des dossiers.
Mais à mesure qu’on scale (des milliers de documents, des corpus qui grandissent, des context windows géants qui tentent de tout avaler) une question se pose : et si le RAG, à force de recycler des contextes de plus en plus similaires, préparait sa propre obsolescence ? Quand votre corpus contient des milliers de chunks sémantiquement proches, le retrieval commence à retourner du bruit indifférencié : un phénomène que certains chercheurs appellent le semantic collapse.
C’est exactement le sujet de mon prochain article. En attendant, voici un exercice concret : uploadez vos cinq derniers documents dans NotebookLM. Posez une question transversale qui nécessite de croiser plusieurs documents. Observez ce que le système retrouve, ce qu’il cite, et ce qu’il manque. Puis lancez un Audio Overview et écoutez vos propres documents racontés par deux voix synthétiques. C’est troublant. C’est efficace. Et c’est la meilleure façon de comprendre viscéralement ce que le RAG fait, et ce qu’il ne fait pas encore.
Écrivez quelques éclats d'âme...
Dans l'ombre vacillante d'une chandelle, où les murmures du vent se mêlent aux secrets d'un vieux parchemin, je vous invite à tisser une toile de mots. Écrivez quelques éclats d'âme – rêve, étoile, abîme, étreinte, brume – et laissez-les danser sur la page, comme des lucioles dans une nuit d'encre. Que diriez-vous de les entrelacer dans une phrase, un souffle, une histoire ?